ニュース
無料会員限定
More efficient machine learning could upend the AI paradigm
エヌビディアが機械学習の「パラダイムを覆す」新手法を研究中
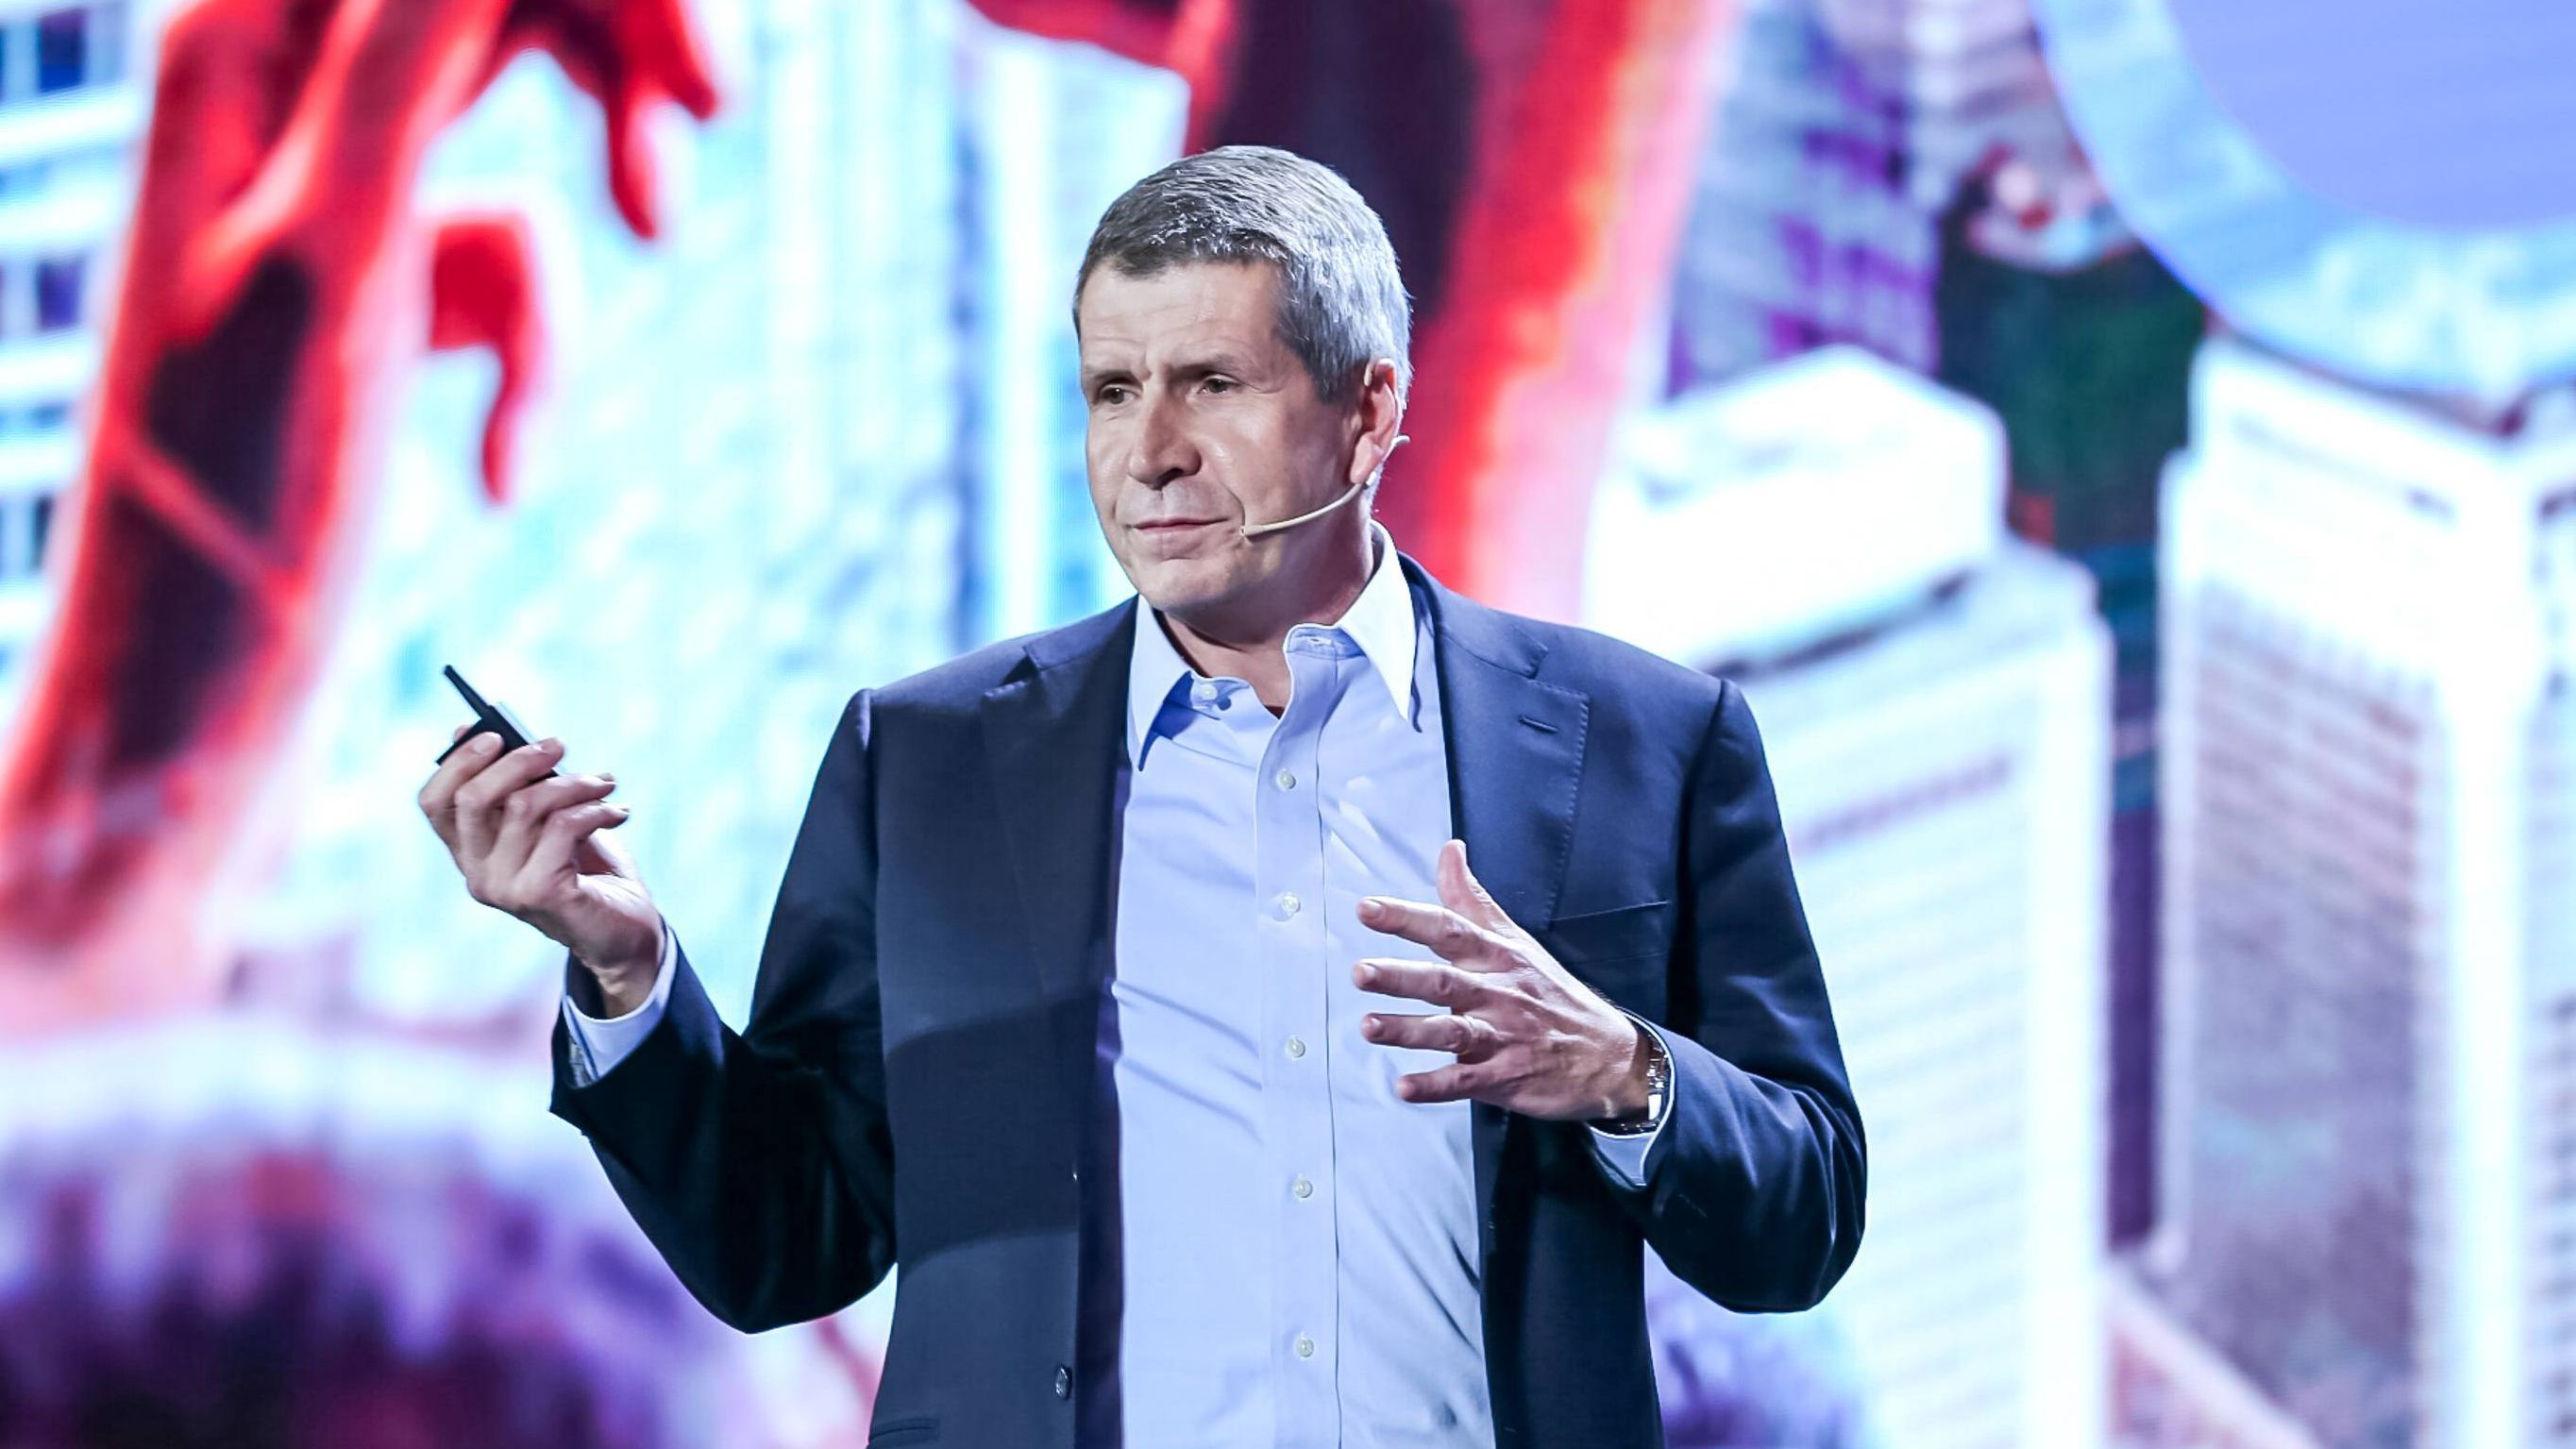
機械学習アルゴリズムを訓練するには膨大なデータが必要だ。少量のデータで訓練できるようになれば現在のパラダイムはひっくり返る。精度を損なうことなくアルゴリズムを小型化する研究を進めていることをエヌビディアの主任科学者が明かした。 by Yiting Sun2018.02.06
グーグルが1月に「クラウド・オートML(Cloud AutoAI)」と呼ばれる新しいサービスを開始した。機械学習ソフトウェアを開発する上での難所のいくつかを自動化できるというものだ。このプロジェクトに取り組んでいる間、強力なアルゴリズムを訓練するために、グーグルの研究者たちは時に800基ものグラフィック・プロセッサー(GPU)を同時に稼働させなければならなかった。
1つか2つの例を目にしただけでコーヒーカップを識別できる人間と違って、シミュレートされたニューロンを基礎とする人工知能(AI)ネットワークが何らかの物体を識別するには、何万もの例が必要となる。そうした方法で身の回りのあらゆる物を認識するように学習しようとすると想像すれば、AIソフトウェアが膨大な演算能力を必要とする理由が分かってくるはずだ。
…
- 人気の記事ランキング
-
- Young organs may not be a fountain of youth for recipients 若い心臓は体に合わせて老いる——プーチンには残念な研究結果
- An AI “mind-reading” tool can reconstruct what you’re looking at from a brain scan 「読心術」AIが飛躍、脳スキャンから「見ているもの」を精密再現
- When can we say AI made a scientific discovery? AIを「発見の主体」に据えるAI企業、科学の営みとのずれ
- She died at the San Diego border. A surveillance camera was in plain sight カメラは何を見ていたのか? 世界有数のAI監視地帯で 移民が亡くなっている