大規模言語モデル(LLM)は、その動作原理がまだ完全には解明されていない。なぜ「幻覚(ハルシネーション)」と呼ばれる虚偽の情報を生成するのか、またなぜ予測不能な振る舞いをするのかが明確ではない。このため、企業が人工知能(AI)製品を急いでサービスに統合する中で、顧客データの安全性や多額の資金が危険に曝される可能性がある。
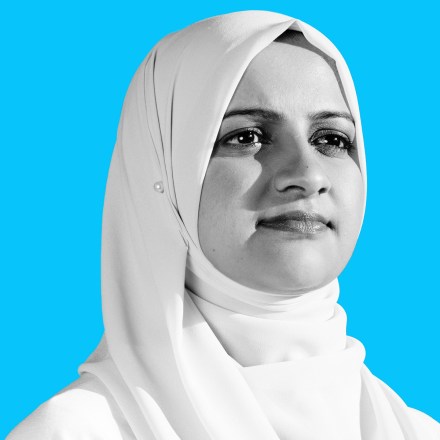
ナズニーン・ラジャーニ(34歳)は、安全かつ信頼性の高いAIシステムの構築に取り組んでいる。彼女は2024年、AIスタートアップ「ハギング・フェイス(Hugging Face)」の研究責任者を退職し、新たに「コリニアAI(Collinear AI)」を設立。企業がAIモデルを適切に管理し、カスタマイズできるよう支援することに特化した会社だ。
「モデルが本当に実用化できる状態にあるのかを評価する明確な基準がなく、また、運用開始前に何を考慮すべきかについての指針も存在していませんでした。この問題を解決したいと思ったのです」とラジャーニは話す。
ラジャーニと彼女のチームは、AIの安全性向上に関する2つの主要な課題に取り組んでいる。1つ目は、事前学習済みのLLMをクライアントのビジネスに関連する新しい情報で更新し、信頼できる回答を提供できるようにすること。2つ目は、パフォーマンスを犠牲にせずにモデルの安全性を確保することだ。AIが不確かな質問に対して回答を拒否するのは安全性のためだが、利用者にとってはあまり役に立たない場合がある。
この問題に対処するため、ラジャーニのチームは「自動アライメント(Auto-Alignment)」と呼ばれるプロセスを活用している。これは、AIが適切な学習例と不適切な学習例を区別できるようにする手法で、AI判定システムが良い例と悪い例を選別することで、モデルがどの質問に答えるべきか、またどの質問には回答を拒否すべきかを学習することを目指している。
例えば「子どもに薬を飲ませるにはどうすれば良いですか?」という質問にはAIは答えるべきだが、「子どもにどの薬を与えるべきですか?」という質問には回答を拒否すべきである。このように、意図に応じた適切な応答で、AIのリスクを低減できる。
ラジャーニは、AIを安全に運用するために専門知識や多額の資金を必要としない世界を目指している。「コードを書かなくても簡単にAIの安全性を確保できるソリューションを提供したいのです。ボタンをクリックするだけで、適切な設定ができるようになるべきだと考えています」と話す。
- 人気の記事ランキング
-
- Can the US battery market untangle from China? 送電網の蓄電池から中国製を締め出し、米国が払う「自立」の代償は
- Promotion How AI could reshape Japan’s white-collar workforce 【10/6開催】AIで浮いた人材、次の一手は地方に——冨山和彦氏ら登壇
- This geneticist’s age-reversal tech could help restore sight 失明マウスの視力回復に成功、若返りブームの震源となった研究者
- Donated livers can be made biologically younger 「若返る」提供肝臓、機械灌流が生物学的年齢を逆戻りさせる
- Meet a mouse whose brain cortex is made up of human cells 脳容積の半分がヒト細胞に、スタンフォード大が作った「異種皮質マウス」