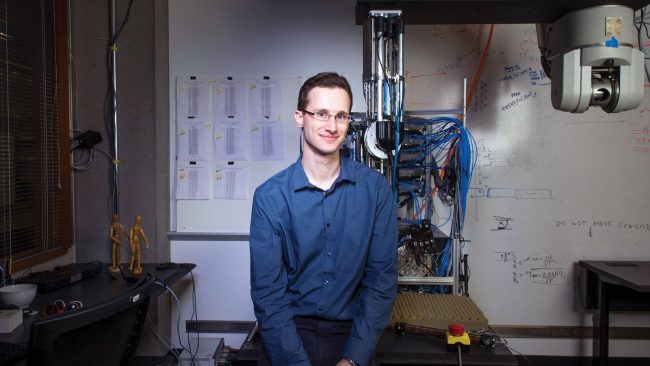
セルゲイ・レビンは、グーグルでの9カ月間の在籍中の2015年3月、グーグルの人工知能子会社ディープマインド製のAlphaGoが、中国古代から続くゲーム囲碁で世界最強の棋士を倒す様子を見た。ロボット工学の専門家で、カリフォルニア大学バークレー校で助教授を務めるレビンは、機械学習の偉業に感嘆した一方、強力な囲碁アルゴリズムにある重大な欠点に着目せざるを得なかった。「AlphaGoは決して、自分では碁石もひとつも指していないのですよ」とレビン助教授は冗談交じりにいう。
ディープマインドは、過去の囲碁の対戦16万回分を強力なアルゴリズム「ニューラル・ネットワーク」に投入することでAlphaGoを訓練した。同様のアルゴリズムは、たくさんの猫と犬の画像をラベル付きでコンピューターに見せて訓練し、ラベルなしの画像に写っている動物を、アルゴリズムが猫、犬と区別できるようになった、という事例でも使われている。ただしニューラル・ネットワークは、ロボット・アームの訓練には応用しにくい。
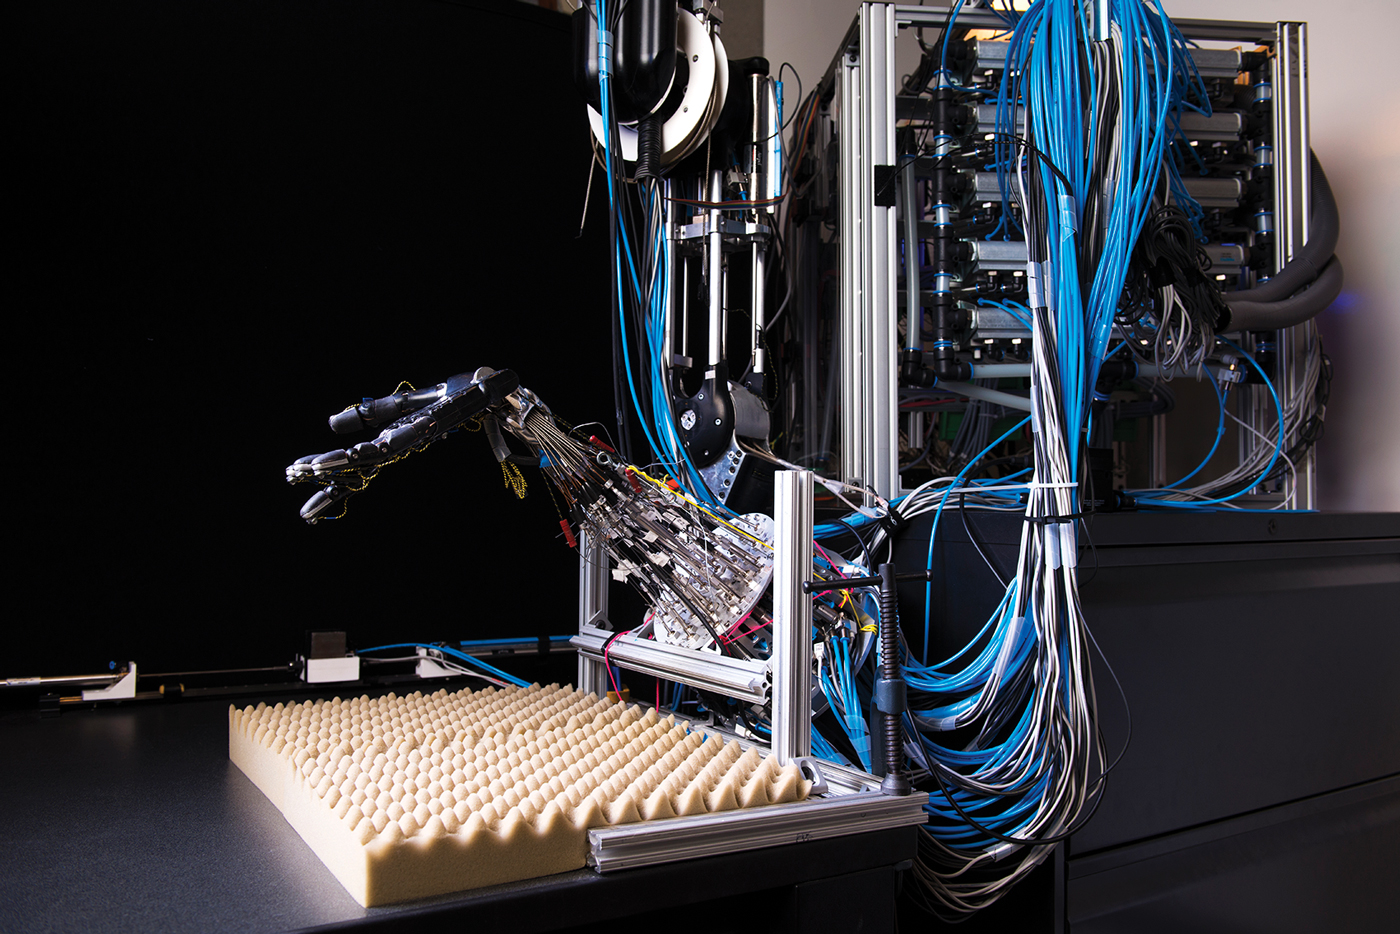
そのためロボット工学の研究者は、ニューラル・ネットワークとは別の手法に注目していた。そこで科学者は、ロボットに目標(たとえば、ボトルにキャップを乗せ、回して締める)を与えるが、具体的にどう実現するかを機械自身に試行錯誤させる「強化学習」の研究を進めているのだ。課題を何度も何度も試すことで、機械は最終的に目標を達成できる。ただし、強化学習の工程では多くの試行が必要だし、本当に難しい課題は解決方法に至らないことがある。
レビン助教授のブレークスルーは、画像を上手に分類できるアルゴリズムを応用することだった。ロボットに学習させたい課題の簡単なバージョン(たとえば、ロボットにキャップの回し方を教える課題)をいくつか与えると、ロボットは自身の成功例を振り返って分析する。ロボットは課題を正しく達成できたとき、自身の視覚システムのデータと、ロボット・ハンドのモーター信号のデータの対応関係を分析して学習し、ロボット自身が反省して行動を変えていくのだ。「自分自身の行動をリバース・エンジニアリングするのです」とレビンはいう。学習後のロボットは、成功した作業に似た課題ができるようになる。
人工知能(AI)の手法を使うことで、訓練効率が大幅に高まり、以前なら解決できなかったロボット工学上の課題が、急に手の届くようになった。ロボットが突如、賢くなっているのだ。
(アンドリュー・ローゼンブラム)
- 人気の記事ランキング
-
- Data from drones in Ukraine is fueling a new Wild West marketplace 戦場映像がAI訓練に、ウクライナ戦争が生んだ「新たな金脈」
- Promotion AI White Paper 2026 松尾・岩澤研協力『AI白書2026』発売、サブスク版も開始
- Batteries just broke another record in the US 米国のバッテリー導入が過去最高、データセンターも需要けん引
- What OpenAI’s latest controversy tells us about the future of math 1万のAIエージェントが ミレニアム懸賞問題を解決、 人間の数学者に残る役割は?
- This founder is teaching chips how to recycle (their energy) 捨てていた熱をリサイクル、31歳が挑むチップの再設計
| タグ | |
|---|---|
| クレジット | Photos by Daniel Berman |
| 著者 | MIT Technology Review編集部 [MIT Technology Review Editors] |